← Voltar para a lista de provas Secretaria de Estado da Fazenda de Sergipe (SEFAZ/SE) · Auditor Fiscal Tributário 30 questões nesta prova · página 1 de 2 · 30 com gabarito Gabarito disponível Dados estruturados: esquema rígido e consulta via SQL. Dados estruturados têm formato e organização definidos por esquemas rígidos, com tipos e restrições por campo, o que permite consultas por linguagens como SQL. A) Podem ser indexados, o que melhora as buscas. B) Não dependem de metadados embutidos em binários para busca. C) Podem estar também em planilhas, arquivos CSV e outros meios. D) Podem conter valores nulos. Referência: Tipos de dados: estruturados, semiestruturados e não estruturados Resolução comentada do VaiConcursos. Gabarito disponível Conceito de dados abertos. Dados abertos são disponibilizados gratuitamente, em formatos abertos e legíveis por máquina, podendo ser livremente utilizados, reutilizados e redistribuídos por qualquer pessoa, exigindo-se no máximo a citação da fonte. A) Dados abertos não exigem cadastro nem proíbem modificação. B) São acessíveis a todos, não só a órgãos governamentais sob confidencialidade. D) Exigem formatos abertos e licenças abertas, não restritivas. E) Não precisam ser atualizados em tempo real. Referência: Princípios dos dados abertos (Open Definition) Resolução comentada do VaiConcursos. Gabarito disponível Modelo unificado e dicionário de dados resolvem conflitos semânticos. Na integração de dados, um modelo unificado e um dicionário de dados corporativo são essenciais para resolver conflitos semânticos entre as fontes e garantir a governança. A) A integração de dados semiestruturados e não estruturados não se limita à replicação. B) Sem políticas de qualidade e validação, as inconsistências não são corrigidas automaticamente. C) O middleware não elimina o mapeamento entre esquemas heterogêneos. E) O ETL tradicional tem limitações para tempo real, mas ELT não é necessário em todos os casos. Referência: Integração de dados – ETL, middleware e governança Resolução comentada do VaiConcursos. Gabarito disponível Banco relacional: tabelas, chaves e integridade no SGBD. Bancos relacionais organizam os dados logicamente em tabelas ligadas por chaves primárias e estrangeiras, e o próprio SGBD suporta a integridade referencial por meio de restrições. B) Descreve o modelo hierárquico. C) A integridade é garantida no SGBD, e não apenas na aplicação. D) O JOIN é central no modelo relacional. E) Podem ser distribuídos e rodar na nuvem. Referência: Modelo relacional Resolução comentada do VaiConcursos. Gabarito disponível Metadados são dados sobre dados. Metadados descrevem outros dados, como conteúdo, contexto, qualidade, formato e restrições de uso, e no SGBD formam o catálogo (dicionário de dados). A) Descreve logs de transação. B) Descreve código/instruções, não metadados. C) Metadados não são backups. D) Descreve os dados da aplicação, não os metadados. Referência: Banco de dados – metadados e dicionário de dados Resolução comentada do VaiConcursos. Gabarito disponível Tabela como materialização de uma relação. No modelo relacional, a tabela materializa uma relação formada por tuplas e atributos; a ordem das linhas é irrelevante, e a das colunas é considerada preservada pelo gabarito, já que as colunas são identificadas na definição da tabela. A) A indexação não é automática para toda consulta e depende de projeto e administração. B) Não se exige mínimo de duas colunas com chave candidata. C) Tabelas são abstrações lógicas, não equivalentes a arquivos físicos. E) Atributos podem ser de vários tipos de dados. Referência: Modelo relacional – relações, tuplas e atributos Resolução comentada do VaiConcursos. Gabarito disponível View como mecanismo de restrição de acesso. Uma view é uma consulta armazenada que pode expor só algumas colunas ou linhas das tabelas-base, funcionando como camada adicional de segurança ao restringir o acesso a dados sensíveis. A) Views podem filtrar e agregar dados. B) Não alteram a estrutura física das tabelas. D) Em geral não armazenam dados (exceto views materializadas). E) Não definem integridade referencial; isso cabe às constraints das tabelas. Referência: SQL – views Resolução comentada do VaiConcursos. Gabarito disponível Índices compostos e ordem das colunas. Índices compostos indexam mais de uma coluna e ajudam consultas que filtram por vários campos; a ordem das colunas importa, pois o otimizador usa o índice conforme o prefixo das colunas consultadas. A) Índices podem prejudicar inserções e atualizações, pois precisam ser mantidos. C) Índices bitmap têm alto custo de manutenção e são indicados para DW, não OLTP com muitas atualizações. D) Só pode haver um índice clusterizado por tabela. E) O índice não clusterizado é uma estrutura separada com ponteiros para os dados, e não mantém cópia ordenada de toda a tabela; ainda pode exigir acesso adicional aos dados. Referência: Bancos de dados relacionais – índices Resolução comentada do VaiConcursos. Gabarito disponível Chave estrangeira e integridade referencial. A chave estrangeira é um campo ou conjunto de campos que referencia a chave primária de outra tabela (ou da mesma), garantindo a integridade referencial entre os registros. A) Descreve chave alternativa. B) Descreve chave composta/primária. C) Não é restrita a tabelas temporárias. E) Descreve a chave primária (única e não nula). Referência: Modelo relacional – chaves e integridade referencial Resolução comentada do VaiConcursos. Gabarito disponível Modelagem dimensional: tabelas fato e dimensão para análise. A modelagem dimensional organiza os dados em tabelas-fato (medidas) e tabelas-dimensão (contexto), estruturas multidimensionais que otimizam consultas analíticas e sumarizações históricas, típicas de data warehouses. A) Usa chaves substitutas e estrangeiras; não as elimina. B) Descreve a modelagem normalizada, adequada a OLTP. C) Não exige JSON; é modelagem relacional/estrela. E) Índices continuam sendo úteis; o esquema estrela não os dispensa. Referência: Data warehouse – modelagem dimensional (Kimball) Resolução comentada do VaiConcursos. Gabarito disponível Discretização baseada em histograma. Na discretização por histograma, os intervalos (faixas de frequência) do histograma são usados para segmentar o atributo, e cada valor é substituído pela faixa em que se encontra. A) A discretização é recomendada justamente para contínuos quando o algoritmo exige atributos categóricos. C) A discretização por entropia é supervisionada e busca maximizar o ganho de informação, mas não é uma 'função linear'. D) O agrupamento (clustering) forma grupos por similaridade, não de modo aleatório. E) O binning suaviza usando média, mediana ou limites das caixas, não limites arbitrários. Referência: Pré-processamento de dados – discretização Resolução comentada do VaiConcursos. Gabarito disponível Overfitting: bom no treino, ruim em dados novos. No sobreajuste o modelo se ajusta excessivamente aos dados de treinamento, representando-os com alta fidelidade, mas generaliza mal e perde desempenho em novos exemplares. A) Avaliar em dados não usados no treino é a forma de detectar o overfitting, não sua causa, e o resultado é ruim. B) Esses modelos representam bem o treino; o desempenho ruim ocorre nos dados novos. C) O fenômeno é prejudicial, pois compromete a generalização. D) Não ocorre apenas com conjuntos pequenos; modelos complexos demais também sobreajustam. Referência: Aprendizado de máquina – generalização e overfitting Resolução comentada do VaiConcursos. Gabarito disponível Árvore de decisão é percorrida da raiz à folha, classificando o exemplar. Um exemplar de teste percorre a árvore da raiz até uma folha, seguindo os testes sobre seus atributos em cada nó, e recebe a classe da folha alcançada. Esse é o mecanismo de classificação das árvores de decisão. A) A impureza é maior quanto mais heterogênea (misturada) é a partição, não mais homogênea. B) Árvores lidam com atributos numéricos, por meio de cortes (limiares). C) Os caminhos representam regras determinadas pelos atributos, não decisões aleatórias. D) São modelos facilmente interpretáveis, o que justifica decisões. Referência: Mineração de dados – classificação por árvores de decisão Resolução comentada do VaiConcursos. Gabarito disponível Confiança de regra no Apriori. A confiança de uma regra A→B é a proporção de transações que contêm A e B em relação às transações que contêm A (antecedente), ou seja, conf = sup(A∪B)/sup(A). A alternativa B descreve isso, embora a expressão 'apenas o antecedente' deva ser lida como 'o antecedente'. A) A quantidade de itens frequentes depende do suporte mínimo e dos dados, não do número de regras. C) Não há relação multiplicativa desse tipo. D) O suporte é a proporção de transações que contêm o conjunto de itens, não razão entre regras e itens frequentes. E) O Apriori usa o suporte mínimo para gerar os conjuntos frequentes; a confiança é aplicada depois, na geração das regras. Referência: Regras de associação – suporte e confiança (Apriori) Resolução comentada do VaiConcursos. Gabarito disponível Limitação do k-means: k deve ser definido previamente. O k-means exige que o número de grupos k seja informado antes da execução, o que é uma limitação clássica, pois nem sempre se conhece o k adequado. Além disso, o resultado depende da inicialização dos centroides. A) Ao contrário, o k-means funciona bem com grupos aproximadamente esféricos; sua limitação é com formatos não esféricos. B) É um algoritmo não supervisionado e não exige rótulos. C) O resultado pode variar conforme a inicialização, podendo cair em ótimos locais. D) Utiliza medidas de distância, geralmente a euclidiana. Referência: Mineração de dados – agrupamento (k-means) Resolução comentada do VaiConcursos. Gabarito disponível Big Data no setor jurídico: volume x veracidade como desafio crítico. Pelo gabarito, o desafio mais comum e crítico é a relação entre volume e veracidade: grande quantidade de dados não garante precisão, e a falta de padronização de documentos exige esforço para assegurar a confiabilidade. Isso envolve diretamente os Vs de volume e veracidade. B) Erra ao dizer que variedade e volume são facilmente superados e que a análise é direta e automatizada. C) Eleva a velocidade a principal desafio, o que não é o consenso; é um exagero absoluto. D) Trata os demais Vs como secundários, o que é indevido. E) Afirma que valor é o V menos importante e que sempre gera insights, o que é falso. Referência: Os 5 Vs do Big Data: volume, velocidade, variedade, veracidade e valor Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Relação entre duas variáveis quantitativas: gráfico de dispersão. O gráfico de dispersão (scatter plot) representa pares de valores de duas variáveis quantitativas e permite visualizar a existência, o sentido e a força da correlação entre elas. Assim, é o mais adequado para relacionar arrecadação e número de fiscalizações. A) Gantt mostra cronogramas de etapas e durações, não relação entre variáveis. B) Pizza mostra proporções de um todo. C) Linhas mostra evolução temporal de uma série. E) Barras compara categorias, não relaciona duas variáveis quantitativas. Referência: Estatística descritiva – representação gráfica de dados Resolução comentada do VaiConcursos. Gabarito disponível PROCV com SE (ou SEERRO) pode validar o código e retornar mensagem de erro. Combinar PROCV com SE, tipicamente via SE(ÉERROS(...)) ou SEERRO, permite retornar o nome do município ou uma mensagem quando o código não existe. B) DATA.VALOR reconhece o formato ISO conforme a configuração regional, não apenas DD/MM/AAAA. C) A tabela dinâmica lista valores distintos sem exigir ordenação prévia. D) CONT.SE funciona com texto também. E) CONCATENAR aceita delimitador, bastando incluí-lo como argumento (" - "). Referência: Microsoft Excel: PROCV, SE, DATA.VALOR, CONT.SE. Resolução comentada do VaiConcursos. Gabarito disponível LEFT JOIN com filtro de data no ON e COUNT da coluna da tabela filha. Para incluir empresas sem auditoria, usa-se LEFT JOIN com o filtro de 2025 no ON (não no WHERE) e COUNT(a.id_auditoria), que ignora NULLs e retorna 0 para quem não tem auditoria. Assim HAVING <= 1 traz nenhuma ou uma.
A) e E) O filtro no WHERE elimina empresas sem auditoria. C) INNER JOIN também exclui quem não tem auditoria. D) Não filtra o ano de 2025, e COUNT(*) conta 1 para empresas sem auditoria. Referência: SQL: LEFT JOIN, COUNT e HAVING. Resolução comentada do VaiConcursos.SEFAZ/SE 2025 — Auditor Fiscal Tributário — Especialidade 1: Auditor Fiscal Tributário – Geral — Prova Objetiva P3 — Conhecimentos Específicos II (tarde)
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
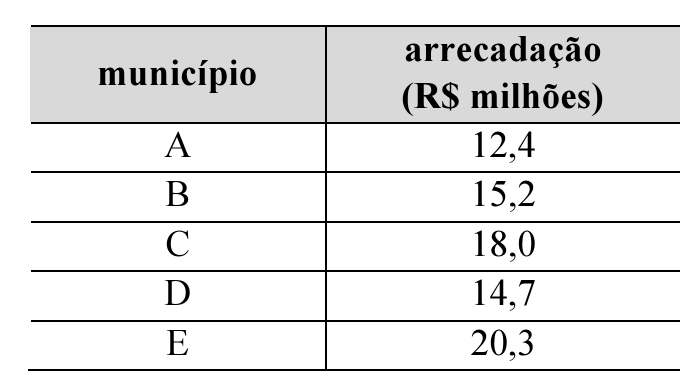
Considerando os dados apresentados na tabela precedente, relativos à arrecadação de ISS de cinco municípios em determinado mês, assinale a opção em que é apresentada uma interpretação correta das medidas descritivas da amostra (média, mediana e desvio padrão).Resolução comentada
Análise das alternativas
Nessa situação hipotética,Resolução comentada
Análise das alternativas
CREATE TABLE auditorias (id_auditoria INT PRIMARY KEY, id_empresa INT, data_auditoria DATE, FOREIGN KEY (id_empresa) REFERENCES empresas(id_empresa));
A partir das tabelas precedentes, referentes a empresas em que foram realizadas auditorias, assinale a opção em que a consulta SQL apresentada retorna corretamente a lista de empresas que foram objeto de nenhuma ou de apenas uma auditoria no ano de 2025.Resolução comentada
Análise das alternativas
Dados estruturados são tipos de dados que
Assinale a opção correta a respeito de dados abertos.
No que diz respeito aos desafios e às técnicas de integração de dados, assinale a opção correta.
Os bancos de dados relacionais
Em um banco de dados relacional, os metadados são
Considerando as características e funções de uma tabela em um banco de dados relacional, assinale a opção correta.
Em bancos de dados relacionais, uma view
Com base nos conceitos relacionados aos índices em bancos de dados relacionais, assinale a opção correta.
Uma chave estrangeira (foreign key) de um banco de dados relacional
Acerca do conceito e da aplicação da modelagem dimensional, assinale a opção correta.
Alguns algoritmos de mineração de dados requerem que os atributos sejam categóricos, o que impossibilita o uso direto de dados numéricos. Para contornar essa limitação, pode-se aplicar a discretização. Acerca desse processo, assinale a opção correta.
No que diz respeito ao fenômeno de sobreajuste (overfitting), assinale a opção correta.
Considerando o contexto da mineração de dados, assinale a opção correta a respeito do funcionamento e das características das árvores de decisão.
Considerando a aplicação do algoritmo Apriori sobre um conjunto de dados transacionais, assinale a opção correta no que concerne aos conceitos envolvidos na geração de regras de associação.
Assinale a opção em que é corretamente apresentada uma limitação do particionamento final produzido pelo algoritmo k-means.
O uso de big data no setor jurídico tem-se mostrado promissor na identificação de padrões em jurisprudências e na otimização de processos. Considerando os 5 Vs do Big Data e a aplicação dessa tecnologia ao setor jurídico, assinale a opção correta.
Caso se pretendesse representar, em um relatório técnico, a relação entre duas variáveis quantitativas de determinado estado — o volume de arrecadação tributária e o número de fiscalizações realizadas —, seria mais adequado o uso de um gráfico de
Um analista de dados da Secretaria de Fazenda do estado X recebeu a incumbência de consolidar dados de repasses intergovernamentais no Microsoft Excel. Com a finalidade de assegurar a consistência e a qualidade dos dados, o analista deve aplicar técnicas de limpeza e transformação.
CREATE TABLE empresas (id_empresa INT PRIMARY KEY, nome_empresa VARCHAR(100), cnpj VARCHAR(18));