← Voltar para a lista de provas Exército Brasileiro — Escola de Saúde e Formação Complementar do Exército (ESFCEx) · Oficial do Quadro Complementar do Exército 60 questões nesta prova · página 2 de 3 · 60 com gabarito Gabarito disponível Gabarito disponível Estimador eficiente (variância mínima) é, por definição, da classe dos não viciados. Eficiência, no sentido clássico (Cramér-Rao), é definida entre estimadores não viciados: o eficiente é o de menor variância nessa classe. Logo, todo estimador eficiente é não viciado. A) Errada: a propriedade de invariância é dos estimadores de máxima verossimilhança, não do método dos momentos. B) Errada: consistência é propriedade assintótica; há estimadores consistentes e viciados (ex.: S² com divisor n). C) Errada: EMV podem ser viciados (ex.: variância da normal com divisor n). D) Errada: EMV são eficientes apenas assintoticamente, sob condições de regularidade. Referência: Teoria da estimação pontual (Cramér-Rao; Mood, Graybill & Boes; Casella & Berger). Resolução comentada do VaiConcursos. Gabarito disponível Aumentar n reduz o erro padrão e a amplitude do IC. O erro padrão do estimador diminui com o aumento de n (por exemplo, σ/√n), e a amplitude do intervalo de confiança diminui junto. A) O erro de estimação é metade da amplitude, ou seja 5, não 10. C) A amplitude é 8,2; o erro seria 4,1 só se o IC fosse simétrico, e o IC da variância não é simétrico em torno do estimador. D) A quantidade pivotal da variância é (n−1)S²/σ², com distribuição qui-quadrado, não t. E) Também não é Normal. Referência: Intervalos de confiança: quantidade pivotal. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Gabarito disponível Gabarito disponível p-valor = P(Z < −3). Como o desvio padrão populacional é conhecido (75), usa-se o teste Z, e H1 é µ < 350. Z = (305 − 350)/(75/√25) = −45/15 = −3, e o p-valor é P(Z < −3) ≈ 0,0013.
B), C) e E) usam valores de X̄ que não correspondem à média amostral observada (305) nem às hipóteses. D) P(Z > 2) seria um teste unilateral à direita com outra estatística. Referência: Teste Z para a média com σ conhecido. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Com mean = 0,10 e 0,12 após um sucesso, obtém-se a = 4,4 e b = 39,6. Seja s = a + b. Então a/s = 0,10 e, após observar uma peça defeituosa, (a + 1)/(s + 1) = 0,12. Substituindo a = 0,1s: 0,1s + 1 = 0,12s + 0,12, logo 0,02s = 0,88 e s = 44. Assim a = 4,4 e b = 39,6. Nas demais, a soma a + b dá 100 (A), 123 (B), 75 (C) e 21 (D), e nenhuma satisfaz a segunda condição de média 0,12 após a atualização. Referência: Inferência bayesiana: Beta-Binomial. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível n ≈ 400 por grupo × 6 grupos = 2 400 alunos. Sem estudo prévio, usa-se p = 0,5. A fórmula simplificada é n0 = 1/E² = 1/0,05² = 400 por grupo (≈ 384 pela fórmula exata). Com 6 grupos de divulgação, o total é 6 × 400 = 2 400. D) 400 vale para um único grupo. C) 800 e E) 1 200 correspondem a 2 e 3 grupos. A) 4 800 corresponde a 12 grupos. Referência: Tamanho de amostra para proporção na AAS. Resolução comentada do VaiConcursos. Gabarito disponível Na alocação proporcional, o tamanho amostral de cada estrato é proporcional ao tamanho do estrato. Na alocação proporcional, n_h = n·N_h/N, de modo que cada estrato contribui para a amostra na proporção do seu tamanho na população. A) A variância do estimador estratificado é uma soma ponderada pelos quadrados dos pesos, não uma simples média das variâncias dos estratos. B) A AE nem sempre é melhor, pois depende da homogeneidade dentro dos estratos. D) Amostragem por cotas é não probabilística, e a AE é probabilística. E) Estratos com médias próximas dão pouco ganho; a escolha da alocação depende também das variâncias e dos custos. Referência: Amostragem estratificada: alocação proporcional. Resolução comentada do VaiConcursos. Gabarito disponível Muitas divisões, heterogêneas e agrupadas por UF, sugerem amostragem por conglomerados em 2 estágios. A população é grande e as divisões formam grupos naturais, associados às UFs. Sortear conglomerados no primeiro estágio e unidades dentro deles no segundo reduz custo e logística. Por isso a amostragem em conglomerados em 2 estágios é a mais indicada. B) A estratificada exigiria pesquisar todos os estratos e não aproveita a estrutura de conglomerados. C) A sistemática exige listagem ordenada e não trata a heterogeneidade. D) A AAS em 2 estágios não explora os grupos naturais. E) Amostragem por cotas é não probabilística. Referência: Planejamento amostral: conglomerados. Resolução comentada do VaiConcursos. Gabarito disponível Na amostragem sistemática com início aleatório entre os K primeiros, cada unidade tem probabilidade 1/K. O ponto de partida é sorteado entre as K primeiras unidades e depois se toma cada K-ésima. Existem K amostras possíveis, igualmente prováveis, então cada indivíduo tem probabilidade 1/K de pertencer à amostra. A) O início deve ser sorteado entre os K primeiros, não entre 2K. C) É probabilístico, pois há sorteio do início. D) É justamente indicada quando não há listagem prévia, como árvores em filas. E) O tamanho da amostra decorre de N/K e da extensão da população, em vez de a seleção parar ao atingir um n fixado. Referência: Amostragem sistemática. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Gabarito disponível Gabarito disponível Gabarito disponível round(NOTA/100)*100 arredonda para o múltiplo de 100 mais próximo. Dividir por 100, arredondar para o inteiro mais próximo com round() e multiplicar por 100 dá o múltiplo de 100 mais próximo, de 0 a 1000. B) ceiling arredonda sempre para cima. C) arred não existe no R. D) trunc corta a parte decimal, arredondando para baixo. E) int não é função do R (seria as.integer, que também trunca). Referência: R: funções de arredondamento. Resolução comentada do VaiConcursos. Gabarito disponível aggregate com fórmula NOTA ~ CODESC e FUN = mean gera a base por escola. A função aggregate aceita fórmula (resposta ~ fator) e aplica FUN a cada nível do fator, devolvendo um data.frame com uma linha por escola. A alternativa E usa essa sintaxe corretamente. A) O argumento by exige uma lista e o comando está mal formado. B) meanbygroup não existe no R base. C) apply não possui argumento fator e não agrupa dessa forma. D) merge serve para juntar tabelas, não para resumir por grupo. Referência: R: aggregate(). Resolução comentada do VaiConcursos.EsFCEx — Concurso de Admissão 2022 — Curso de Formação de Oficiais do Quadro Complementar — Área: Estatística — 007. Prova Objetiva — Versão A
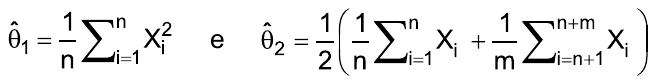
Uma das propriedades desejáveis de um estimador é que ele tenha um erro quadrático médio pequeno. O estimador θ̂₂ terá erro quadrático médio menor que o estimador θ̂₁ se, e somente se:Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
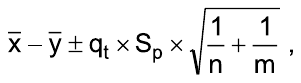
com x̄ representando a média observada em uma amostra aleatória de tamanho n da população X, ȳ a média observada em uma amostra aleatória de tamanho m da população Y, Sₚ é o desvio padrão amostral combinado observado nas amostras, e qₜ é um quantil da distribuição t-Student. Se y é o coeficiente de confiança desejado no intervalo e Tc representa a distribuição t-Student com c graus de liberdade, o quantil qₜ deve satisfazer a seguinte probabilidade:
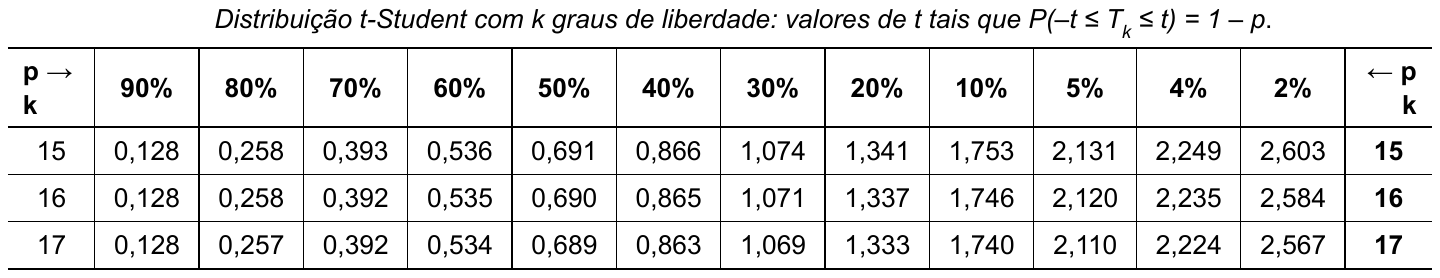
Com base na tabela a seguir e adotando um nível de significância de 5%, qual é a região crítica do teste (RC) e a decisão tomada?
Erro Tipo I: dizer que os tiros foram dados pelo João, quando, na realidade, foram dados pelo Antônio.
Erro Tipo II: dizer que os tiros foram dados pelo Antônio, quando, na realidade, foram dados pelo João.
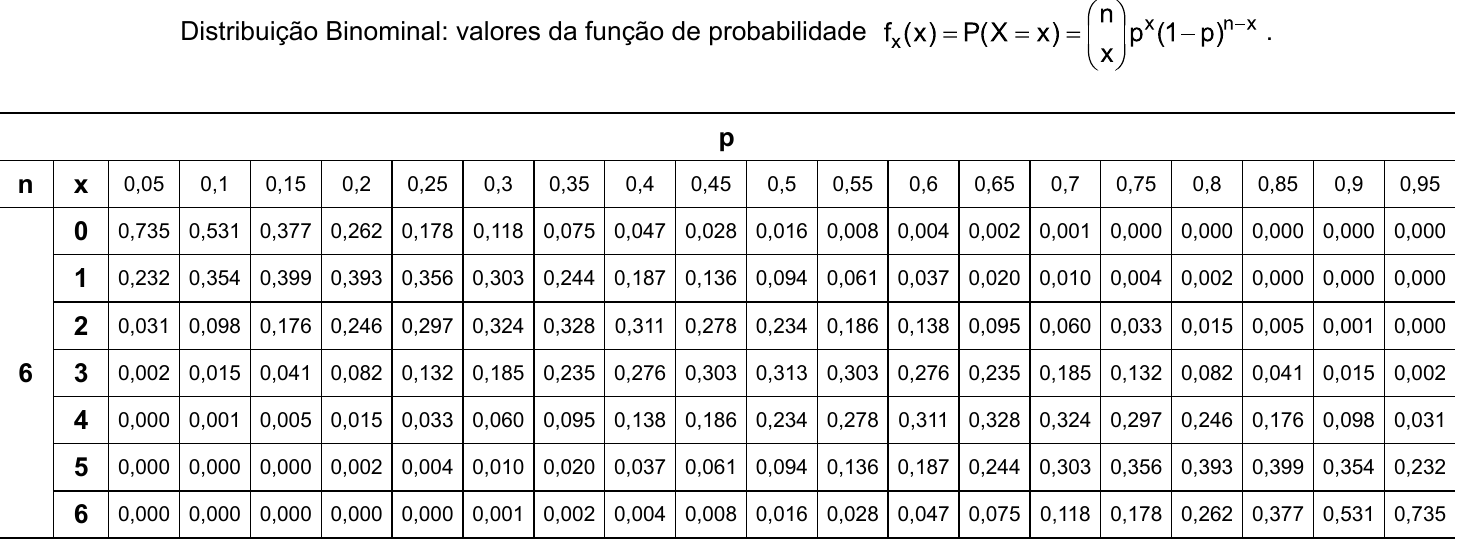
As probabilidades dos Erros Tipo I e Tipo II são, respectivamente,Resolução comentada
Análise das alternativas
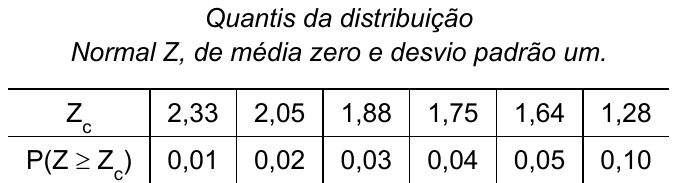
Qual é o valor aproximado de “n” de forma que as probabilidades de cometer o Erro Tipo I e o Erro Tipo II sejam ambas iguais a 0,05?Resolução comentada
Análise das alternativas
L₀: perda sofrida, ao decidir que o jogador não deve ser contratado, quando ele deveria ser contratado;
L₁: perda sofrida, ao decidir que o jogador deve ser contratado, quando ele não deveria ser contratado.
Adotando-se a função densidade a priori π(θ) = 2θ, 0 < θ < 1 para a proporção θ, e sabendo que, no teste realizado, o jogador acertou 4 arremessos de 3 pontos em n = 4 lançamentos, o time deve rejeitar a hipótese H₀ se:Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
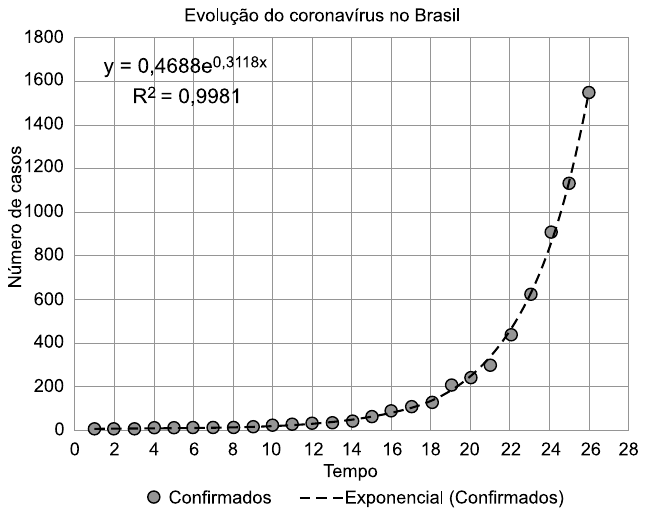
Dados: LN(213 × 10⁶) = 19,2; LN(0,4688) = − 07576.
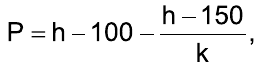 em que K = 4 para ingressantes do sexo masculino e K = 2 para ingressantes do sexo feminino, com P em Kg e h em centímetros. Tem-se também que
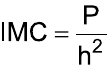 , usado com h em metros. Pode-se afirmar que
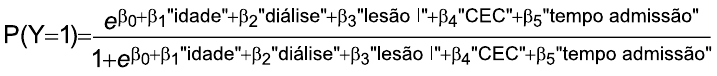
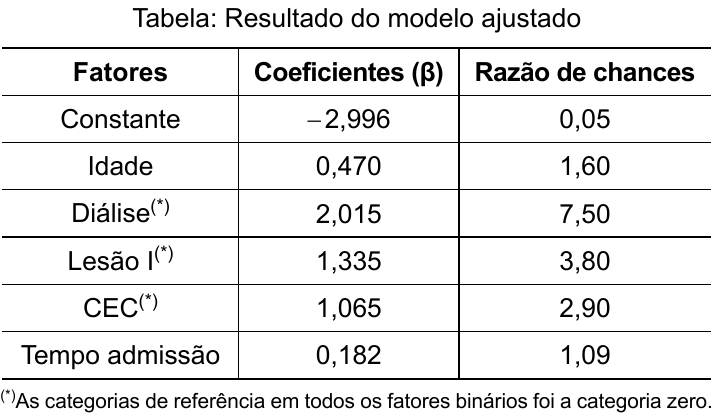
Considere as seguintes afirmativas sobre o resultado do modelo ajustado.
I. A idade do paciente e o tempo entre a admissão hospitalar e a cirurgia têm uma associação inversa ao óbito, ou seja, valores maiores diminuem a probabilidade de o paciente vir a óbito.
II. Com relação à necessidade de diálise, a chance relativa de óbito nos pacientes com necessidade desse tratamento no pós-operatório é 650% maior do que aqueles não submetidos à diálise.
III. O aumento de um dia no tempo entre a admissão no hospital e a cirurgia aumenta a chance relativa de óbito do paciente em cerca de 9%.
IV. O aumento de 3 anos na idade do paciente aumenta em cerca de 310% (1,6³ = 4,10) a chance relativa de óbito do paciente.
Avaliando as afirmações I, II, III e IV como verdadeiras (V) ou falsas (F), tem-se respectivamente:
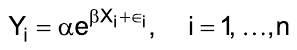
Se 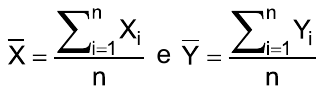 são as médias amostrais, os estimadores de mínimos quadrados dos parâmetros α e β são dados por:
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
A fim de estimar a probabilidade θ de sucesso em uma população X ~ Bernoulli (θ), foi conduzido o seguinte experimento em duas etapas: inicialmente, observou-se uma amostra aleatória X₁, … , Xₙ, de tamanho n e, em seguida, observou-se uma nova amostra aleatória Xₙ₊₁, …, Xₙ₊ₘ, de tamanho m, independentemente da primeira amostra. Suponha que os seguintes estimadores estão sendo propostos para θ:
Com relação às propriedades dos estimadores e aos diferentes métodos de estimação, pode-se afirmar que
No processo de estimação de parâmetros associados à distribuição de uma variável aleatória X, através de intervalos de confiança baseados no método da quantidade pivotal, pode-se afirmar que
Uma forma de comparar as médias µₓ e µᵧ de duas populações normais independentes X e Y, respectivamente, com variância comum e desconhecida σ², é através do Intervalo de confiança para a diferença entre as médias, dado por
A fim de combater o desperdício e diminuir o consumo (em kWh: Quilowatt-hora) de energia elétrica em empresas de pequeno porte de uma região, uma consultoria especializada foi contratada e implementou algumas medidas para melhorar a eficiência energética. Para acompanhar a redução no consumo de energia com as novas medidas, a consultoria selecionou uma amostra de n = 16 empresas da região e registrou o consumo antes (variável X) e após (variável Y) a implementação das medidas propostas. Foram observados, antes das novas medidas, um consumo médio entre as empresas selecionadas x̄ = 350 kWh e, após as novas medidas, um consumo médio ȳ = 320 kWh. Suponha que a diferença entre os consumos, D = X − Y, segue uma distribuição Normal, e que o desvio padrão dessas diferenças entre as empresas selecionadas foi SD = 40 kW/h. Deseja-se testar a hipótese de que houve redução no consumo com as novas medidas.
João e Antônio são atletas de tiro esportivo, cujas chances de acertarem o alvo são 90% e 75%, respectivamente. Suponha que um deles é selecionado ao acaso e executa 6 tiros. Para decidir qual deles executou os tiros, adotou-se a regra: se o atirador acertar o alvo nos 6 tiros, diremos que o João foi o atirador; caso contrário, diremos que foi o Antônio. Usando a tabela da distribuição Binomial a seguir, obtenha as probabilidades dos Erros Tipo I e Tipo II, definidos como:
Sabe-se que, na última safra, o custo médio do frete de itens agrícolas, para distâncias em torno de 800 km, foi de R$ 350,00 com um desvio padrão de R$ 75,00. Para a safra atual, os produtores adotaram novas estratégias no planejamento e na logística do transporte da produção, a fim de diminuir esse custo médio. Assumindo que as novas estratégias não modificaram o desvio padrão do custo na safra atual e supondo normalidade na distribuição da variável custo, deseja-se verificar se as mudanças foram eficazes. Para o teste das hipóteses de interesse, foram registrados os custos do frete na safra atual (para distâncias em torno de 800 km) de uma amostra de 25 produtores, cuja média e desvio padrão amostral foram, respectivamente, x̄ = R$ 305,00 e s = R$ 70,00. Assim, o p-valor (ou nível descritivo) do teste é aproximadamente p = 0,0013, e conclui-se que as mudanças foram eficazes na redução do custo. Seja Z uma variável com distribuição Normal de média zero e desvio padrão um, e seja X̄ a estatística que representa a média amostral, o p-valor foi obtido como a seguinte probabilidade:
O comprimento X das fibras de algodão é uma das características determinantes da qualidade da produção na indústria têxtil. Suponha que a variável X tenha distribuição Normal com média µ e desvio padrão σ que dependem do fornecedor. Uma indústria recebe um lote dessas fibras, que podem ter vindo do fornecedor A ou do fornecedor B, cujos parâmetros na distribuição de X são, respectivamente: (µA = 33; σA = 3) e (µB = 36; σA = 6). Para decidir se o lote veio do fornecedor A (hipótese H₀) ou do fornecedor B (hipótese H₁), a indústria resolve selecionar uma amostra de tamanho “n” das fibras do lote e, se o comprimento médio das fibras selecionadas for grande (x̄ > k), onde k é uma constante, a indústria decide que o lote veio do fornecedor B; caso contrário, decide que veio do fornecedor A. Considere a seguinte tabela, que apresenta quantis da distribuição Normal de média zero e desvio padrão um.
Uma indústria deseja estimar a proporção p de rolamentos em sua linha de produção que não satisfazem as especificações técnicas. Para isso, adota-se para p uma distribuição a priori conjugada Beta com parâmetros a e b. Na especificação dos parâmetros da priori o estatístico consulta um engenheiro especialista e solicita que ele, com base em sua experiência, dê sua opinião (estimativa) sobre o valor esperado de p. O engenheiro apresenta o valor 0,10. O estatístico agradece e pede para o engenheiro supor que, ao selecionar um rolamento na linha de produção, verificou-se que estava fora das especificações técnicas. Em seguida, solicita ao engenheiro uma segunda opinião sobre o valor esperado de p diante da informação adicional, e o engenheiro atualiza sua opinião para o valor 0,12. Os valores de a e b, segundo a opinião do especialista, são:
Um time de basquete deseja contratar um jogador para reforçar o seu time no próximo campeonato. O critério para a contratação será a sua proporção θ de acertos nos arremessos de 3 pontos: o jogador será contratado se θ ≥ 0,8. O time fará um teste com o provável contratado, e observará o total y de acertos em n arremessos de 3 pontos. Com o resultado do teste, o time pretende decidir entre as hipóteses: H₀ : θ ≥ 0,8 (contrata o jogador) ou H₁ : θ < 0,8 (não contrata o jogador). No contexto de uma decisão bayesiana, suponha que as perdas envolvidas são:
O Exército deseja fazer uma pesquisa com os alunos dos três anos do ensino médio atendidos nas suas diversas escolas, considerando 2 (duas) características: (1) ano/série; (2) sexo, compondo 6 (seis) grupos de pesquisa para fins de divulgação. Não há estudo similar ou prévio. A decisão é de que o erro de estimativa seja de 5% com confiança de 95% por grupo. Nesse contexto, o Estatístico usa uma fórmula simplificada no esquema de Amostragem Aleatória Simples (AAS) e indica que o tamanho amostral deve ser, aproximadamente,
A Amostragem Estratificada (AE) consiste na subdivisão de uma população em grupos (estratos) segundo uma ou mais características conhecidas na população em estudo, e, de cada um desses grupos, são selecionadas amostras em proporções convenientes. Nessa situação, pode-se afirmar que
O Comando do Exército decidiu realizar uma pesquisa para avaliar a Qualidade de Vida dentro das suas divisões. O número de divisões associado às Unidades da Federação (UF) forma um conjunto bastante grande e com considerável heterogeneidade com relação às UFs e ao tamanho da divisão. Nessa situação, o planejamento amostral mais indicado é Amostragem
Em uma pesquisa envolvendo plantações de eucalipto, com as árvores dispostas em filas, verifica-se que não existe disponível uma listagem de indivíduos da população (árvores) a partir da qual seja viável selecionar aleatoriamente uma amostra. O Estatístico seleciona apenas um indivíduo entre os K primeiros, e, a partir deste, cada K-ésimo indivíduo é selecionado deterministicamente para compor a amostra. Sobre esse planejamento experimental, pode-se afirmar que
A evolução do número de infectados pelo coronavírus no Brasil (y) apresentou um crescimento exponencial em função do número de dias (d) após o primeiro caso confirmado no dia 26 de fevereiro de 2020. No 26º dia, já havia cerca de 1 500 casos confirmados. As estimativas do modelo exponencial y = aeᵇᵈ são â = 0,4688 e b̂ = 0,3118 para os 26 primeiros dias, com coeficiente de explicação de 0,9981, apresentados no gráfico. Sabe-se que este modelo pode ser linearizado. Considerando não haver mudança no comportamento da população e ser possível a infecção de uma população inteira, o tempo para o contágio de 213 milhões de pessoas seria de, aproximadamente,
O Comando do Exército está avaliando características físicas dos ingressantes. A primeira delas avalia a relação entre peso (P) e altura (h) e o Índice de Massa Corpórea (IMC), e adotou-se a Fórmula de Lorentz para estimar o peso ideal através da altura, dada por
Um modelo de regressão logística foi usado na identificação de fatores de risco para mortalidade de pacientes submetidos à cirurgia de revascularização do miocárdio com circulação sanguínea extracorpórea. Os seguintes fatores foram significativos no modelo: idade do paciente (em anos), necessidade de diálise no pós-operatório (0 – não; 1 – sim), lesão neurológica tipo I (0 – não; 1 – sim), CEC – tempo de circulação extracorpórea (0 – menor que 90 minutos; 1 – maior que 90 minutos) e o tempo entre a admissão hospitalar e a cirurgia (em dias). A tabela a seguir apresenta o resultado do ajuste do modelo logístico binário para a variável resposta Y (0 – não óbito; 1 – óbito), com as estimativas dos coeficientes e a razão de chances (odds ratio):
Considere o seguinte modelo de regressão entre as variáveis X e Y:
Uma variável contínua pode ser categorizada de diversas formas, inclusive com transformações. Considerando uma variável NOTA do ENEM, basicamente no intervalo de 0 (zero) a 1 000, deseja-se transformar cada valor para o inteiro mais próximo que seja múltiplo de 100, incluindo o zero (0, 100, 200, ..., 900, 1 000). A transformação NOTAT no software R que produz esse resultado é:
O Estatístico frequentemente precisa construir medidas resumo por nível de um fator. Por exemplo, com uma base de dados de alunos de diversas escolas, um dos objetivos é construir uma base em que cada linha contém as medidas de cada escola, como média e desvio-padrão. Considerando um data.frame com 2 colunas, contendo o Código da Escola (CODESC) e a NOTA, o comando que produz essa base pode ser obtido por: