← Voltar para a lista de provas Exército Brasileiro — Escola de Saúde e Formação Complementar do Exército (ESFCEx) · Oficial do Quadro Complementar do Exército 60 questões nesta prova · página 3 de 3 · 60 com gabarito Gabarito disponível Diferenças entre inferência clássica e bayesiana. No paradigma bayesiano, o Teorema de Bayes combina a priori com a verossimilhança para gerar a posteriori. A posteriori resume o conhecimento atualizado sobre o parâmetro. A) Errada: na abordagem bayesiana o parâmetro é aleatório, não fixo. B) Errada: a posteriori é o resultado da atualização, e não uma informação usada para atualizá-la. C) Errada: na inferência clássica o parâmetro é fixo e desconhecido. D) Errada: a forma mais completa de expressar o conhecimento na abordagem bayesiana é a distribuição a posteriori, não a verossimilhança. Referência: Teorema de Bayes: posteriori ∝ verossimilhança × priori. Resolução comentada do VaiConcursos. Gabarito disponível Motivação para o uso de priori conjugada. Escolher uma priori conjugada indica busca por simplicidade, porque a posteriori pertence à mesma família da priori e tem forma fechada. Além disso, os hiperparâmetros da posteriori ficam facilmente interpretáveis, por exemplo como 'dados fictícios' adicionais. A) Errada: no modelo Binomial a conjugada é a Beta, não a Binomial, e a afirmação sobre o modelo Normal está mal formulada. B) Errada: com dados muito informativos, a verossimilhança domina e a priori tem pouca influência, mas a frase está mal formulada ao dizer que a priori influencia pouco 'sobre a verossimilhança'. D) Errada: a posteriori combina priori e verossimilhança e não é equivalente à verossimilhança. E) Errada: priori não informativa e priori conjugada são conceitos distintos, e os resultados dependem da escolha. Referência: Inferência Bayesiana — prioris conjugadas (Gamerman & Lopes; Paulino et al.). Resolução comentada do VaiConcursos. Gabarito disponível IC de 95% para proporção com p̂=0,5 e n=64. Com p̂=32/64=0,5, o erro-padrão é √(0,25/64)=0,0625. Usando z=1,96, a margem é 1,96×0,0625=0,1225, e o intervalo é 0,5±0,1225=[0,3775; 0,6225], que arredondado dá [0,38; 0,62]. O IC clássico para proporção usa a normal, não a t. A) Seria o caso de uma margem de 0,10, o que não corresponde ao cálculo. B) Margem de 0,11, o que não corresponde ao cálculo. C) Intervalo assimétrico em torno de 0,5, o que é impossível. D) Também assimétrico. Apenas E, de 0,38 a 0,62, é simétrico e corresponde ao resultado. Referência: IC para proporção: p̂ ± z·√(p̂(1−p̂)/n). Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Propriedades assintóticas dos estimadores de máxima verossimilhança (EMV). Sob condições gerais de regularidade, o EMV é assintoticamente não viciado, consistente e eficiente. Para n grande, seu viés tende a zero e sua variância se aproxima do limite de Cramér-Rao, que é a menor variância atingível. A) Errada: nem sempre é fácil maximizar a verossimilhança, e muitas vezes é preciso usar métodos numéricos. B) Errada: os estimadores de momentos nem sempre são não viesados, e os de mínimos quadrados só têm variância mínima sob condições específicas (Gauss-Markov). C) Errada: o princípio dos mínimos quadrados busca minimizar a soma de quadrados, não maximizá-la. E) Errada: os estimadores de momentos costumam ser mais simples de obter, e as equações envolvem os parâmetros desconhecidos, não parâmetros conhecidos. Referência: Casella & Berger, Inferência Estatística; Mood, Graybill & Boes. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Gabarito disponível A inclinação −0,04 indica queda de 0,04 acidente por hora de treinamento. No modelo ŷ = 7,72 − 0,04x, o coeficiente angular é −0,04. Em média, cada hora adicional de treinamento reduz em 0,04 o número esperado de acidentes. A) O coeficiente linear (intercepto) é 7,72, e a reta é decrescente. C) Sem treinamento (x=0), espera-se 7,72 acidentes, não 19. D) O coeficiente angular é −0,04 e a reta é decrescente. E) Para x=45, ŷ = 7,72 − 1,8 = 5,92, não 9. Referência: Regressão linear simples: interpretação dos coeficientes. Resolução comentada do VaiConcursos. Gabarito disponível Com p=0,4071 > 0,05, não se rejeita H0, e as variáveis são tratadas como independentes (sem correlação linear). O valor-p de 0,4071 é maior que 0,05, então não há evidência para rejeitar H0: ρ=0. Conclui-se que não há associação linear significativa, ou seja, as variáveis podem ser consideradas independentes. A) Não rejeitar H0 não leva à conclusão de dependência. B), C) e D) afirmam rejeição de H0, o que contraria p > α. Falar em correlação espúria também não se sustenta. Referência: Teste de hipótese para o coeficiente de correlação de Pearson. Resolução comentada do VaiConcursos. Gabarito disponível Na regressão logística binária, a resposta é 0/1, a relação é não linear e a variância depende da média. A regressão logística é indicada para resposta binária (0 ou 1). A função resposta é não linear (sigmoide), a variância da resposta é p(1−p), isto é, função da média, e os erros não podem ser tratados como normais. A) A resposta não é quantitativa discreta e os erros não são normais. B) Os erros não são normais e a função não é simétrica por exigência. C) A função não tem formato de 'U' e a variância não é constante. D) Trata de duas respostas quantitativas, o que não é regressão logística. Referência: Kutner et al., Applied Linear Statistical Models: regressão logística. Resolução comentada do VaiConcursos. Gabarito disponível Médias por grupo no R: tapply(Y, X, mean). A função tapply aplica uma função a uma variável numérica agrupada por um fator. Assim, tapply(Y, X, mean) calcula a média salarial por função. A) e C) apply atua em linhas ou colunas de matrizes. B) mean(Y, X) não agrupa. E) 'media' não é função do R base. Referência: Documentação do R: função tapply. Resolução comentada do VaiConcursos. Gabarito disponível No R, ajusta-se com lm(Y~X, data=dados) e testa-se o modelo com anova(). A regressão linear simples é ajustada por Reg=lm(Y~X, data=dados), e anova(Reg) fornece o teste F de significância do modelo. A) e E) 'Reg()' não é função de ajuste. B) lm não usa essa sintaxe com vírgula nem o argumento test. D) lm(Y,X) está incorreto, a fórmula deve ser Y~X, e test() não existe. Referência: Documentação do R: funções lm e anova. Resolução comentada do VaiConcursos. Gabarito disponível O nível de significância α é a probabilidade do erro tipo I: rejeitar H0 sendo verdadeira. O nível de significância α é a probabilidade de cometer o erro tipo I, isto é, rejeitar a hipótese nula quando ela é verdadeira. B) Descreve o erro tipo II (β), que não é α. C) Não rejeitar H0 verdadeira é uma decisão correta. D) Rejeitar H0 falsa é decisão correta (poder do teste). E) Rejeitar H0 verdadeira é erro tipo I, não tipo II. Referência: Inferência estatística: testes de hipóteses. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível t = 2,67 > 1,753, então rejeita-se H0 e há evidência de aumento. Com H0: μ=10 contra H1: μ>10, σ desconhecido e n=16, usa-se t = (12−10)/(3/√16) = 2/0,75 ≈ 2,67. Como 2,67 > 1,753 (t crítico unilateral a 5% com 15 gl), rejeita-se H0 e há evidência de aumento. A) O valor de t calculado está errado (2,67, e não 1,72). B) O valor de t está errado e a conclusão seria incoerente. C) Usa z, inadequado com σ desconhecido e n pequeno, e conclui 'não' ao rejeitar H0. E) Usa z e afirma 'sim' ao não rejeitar H0, o que é contraditório. Referência: Teste t para a média de uma amostra. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Gabarito disponível O número de amostras é C(20,3) = 1140. Em amostragem sem reposição e sem importar a ordem, o número de amostras distintas é a combinação C(20,3) = 20·19·18/(3·2·1) = 1140. A) 6840 é o arranjo A(20,3), que considera a ordem. C) 6 é 3!. D) e E) não correspondem ao cálculo. Referência: Combinatória aplicada à amostragem aleatória simples. Resolução comentada do VaiConcursos. Gabarito disponível Gabarito disponível Teste t unilateral no R: t.test(tempo, mu=30, alternative='greater'). Para H0: μ=30 contra H1: μ>30 com uma amostra, cria-se o vetor com c() e usa-se t.test com mu=30 e alternative='greater'. O argumento paired=FALSE é compatível com uma amostra. B) A função 'teste' não existe e 'media' não é argumento. C) Os valores não foram criados com c(), o que gera erro. D) 'data()' e 'teste' não servem e 'less' testa o oposto. E) 'media' não é argumento válido e paired=TRUE não se aplica a uma amostra. Referência: Documentação do R: função t.test (pacote stats). Resolução comentada do VaiConcursos.EsFCEx — Concurso de Admissão 2023 — Curso de Formação de Oficiais do Quadro Complementar — Área: Estatística — 007. Prova Objetiva — Versão A
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
E(.) é a função esperança;
Var(.) é a função variância;
B(.) é a função viés; e

Sobre as propriedades desejáveis dos estimadores, assinale a alternativa correta.Resolução comentada
Análise das alternativas
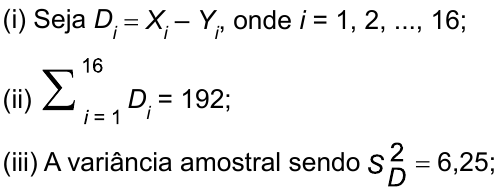
(iv) P(T > 1,341) = 0,10; P(T > 1,753) = 0,05; P(T > 2,131) = 0,025, em que T é uma variável aleatória contínua com distribuição t de Student com 15 graus de liberdade.
O intervalo de confiança de 90% e a conclusão desse estudo foram, respectivamente:
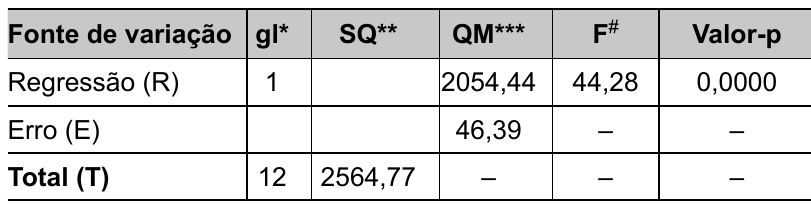
* gl: graus de liberdade;
** SQ: Soma de quadrados
*** QM: Quadrado médio;
#F: Valor F calculado.
Com base no exposto, é correto afirmar que
ŷ = 7,72 – 0,04 x, para 0 ≤ x ≤ 54
Com relação ao exposto, é correto afirmar:Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Um fabricante realiza periodicamente uma pesquisa para verificar a aceitação do seu produto. Para manter o produto no mercado, o fabricante precisa que a proporção de consumidores satisfeitos seja de pelo menos 0,90. Realizou-se uma pesquisa com 100 consumidores, dos quais 85 relataram que estão satisfeitos com o produto. Esses dados mostram que o fabricante deve retirar o produto do mercado?
Dado: φ(1,645)=0,95, φ (1,96)=0,975, F(1,753)=0,95, F(2,131)=0,975; sendo φ a função de distribuição acumulada normal padrão e F a função de distribuição acumulada t de Student com 15 graus de liberdade.Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
Resolução comentada
Análise das alternativas
O comandante do exército solicita ao oficial, especialista em estatística, uma análise dos dados obtidos em sua missão para poder tomar decisões em relação aos próximos passos. Nessa primeira conversa, o oficial pergunta ao comandante qual é o tipo de inferência que ele deseja que seja realizada. Em relação aos dois tipos de inferência (Clássica ou Bayesiana) é correto afirmar:
Um dos grandes desafios do uso da inferência Bayesiana é a especificação da distribuição a priori dos parâmetros do(s) modelo(s), pois cada problema é único e tem um contexto real próprio e os graus de conhecimento variam de pesquisador para pesquisador. No processo de elicitação (especificação de distribuições de probabilidade para os parâmetros baseado em crenças e conhecimentos de uma ou mais pessoas), sobre o uso de priori(s) é correto afirmar que
Para que novas estratégias de treinamento possam ser pensadas, uma escola de tiro gostaria de avaliar o treinamento dado aos seus alunos. Dessa forma, sorteou-se 64 alunos com o mesmo tempo de horas de treinamento e cada um destes realizou apenas um tiro. Destes, 32 acertaram o alvo. Considere que a probabilidade de um aluno acertar o alvo seja a mesma para todos e que os alunos são independentes entre si. Dado φ(1,645)=0,95, φ(1,96)=0,975, F(1,696)=0,95, F(2,04)=0,975; sendo φ a função de distribuição normal padrão e F a função de distribuição acumulada t de Student com 31 graus de liberdade. A estimativa intervalar clássica para essa situação, considerando um nível de significância de 5%, será:
A inferência estatística tem por objetivo fazer generalizações sobre uma população com base nos dados de amostra. Um dos itens básicos nesse processo é a estimação de parâmetros, que pode ser realizado por ponto ou por intervalo. Um estimador θ̂ do parâmetro θ é qualquer função das observações de uma amostra aleatória de tamanho n da variável X com função de distribuição de probabilidade (ou função de probabilidade), f(X|θ), ou seja, θ̂ = f(X₁, X2, ..., Xₙ). Logo, um estimador também é uma variável aleatória. Considerando que:
As definições e outras propriedades de estimadores não fornecem qualquer orientação acerca de como bons estimadores podem ser obtidos. Por essa necessidade, surgem alguns métodos de estimação pontual; entre esses, os mais usados são o método dos momentos, o método dos mínimos quadrados e o método da máxima verossimilhança. Em relação a estes métodos de estimação, é correto afirmar:
Pensando na saúde dos novos cadetes, para avaliar a efetividade de uma dieta combinada com um programa de exercícios físicos no controle de triglicerídeos, 16 cadetes foram sorteados para participar de um estudo. Avaliou-se a taxa de triglicerídeos antes (ml/dL) de começar a dieta com o programa e eles foram reavaliados após a dieta com o programa. Deseja-se verificar se as taxas de triglicerídeos antes (X) e depois (Y) da dieta com esse programa de exercícios físicos são iguais. Considere as seguintes informações:
Para um estudo de saúde foram avaliadas as idades de 13 homens, relacionando-as com sua pressão arterial (mmHg). Devido ao comportamento e a associação dessas variáveis, foi inicialmente ajustado um modelo de regressão linear simples, sendo a idade a variável independente. O quadro da análise de variância deste modelo de regressão trouxe as informações a seguir:
Fazer diversos treinamentos para saber como agir diante de situações de emergências é uma das principais exigências para se trabalhar em áreas em que a tomada de decisão deve ser feita com urgência. No intuito de reforçar e ilustrar esse conceito aos novos ingressantes no serviço militar, um estudo, com 10 alunos, foi realizado, associando o número de horas de treinamento de cada indivíduo (X) com o número de acidentes causados(Y). Supondo que todas as pressuposições necessárias para a obtenção de um modelo de regressão linear simples foram satisfeitas, e que esse modelo se ajustou bem aos dados, o modelo estimado obtido foi:
Na possibilidade de exemplificar o fenômeno de como os exercícios aeróbicos e a ingestão de calorias podem afetar o peso, quarenta oficiais recém ingressados no exército aceitaram participar de um estudo e, durante uma semana, anotou-se minuciosamente o número de minutos de exercícios aeróbicos que praticaram, junto com sua ingestão calórica (Kcal) diária. Desses dados, primeiramente, avaliou-se a associação entre as variáveis X = ‘tempo de exercício físico realizado’ e Y = ‘calorias ingeridas’ por meio de um gráfico de dispersão. Deste gráfico não se pode concluir muita coisa, por esse motivo, quantificou-se essa associação, resultando em um coeficiente de correlação r = – 0,2515. Para confirmar a existência de associação ou não entre as variáveis, aplicou-se o teste de hipótese para correlação zero, ou seja, H₀: ρ = 0 (sendo ρ o coeficiente de correlação linear de Pearson populacional), obtendo-se um valor-p de 0,4071. Considere que ambas as variáveis possuem distribuição normal e que para todas as análises necessárias fixou-se um nível de confiança de 95%. Assim, é possível afirmar corretamente que:
Um estatístico recém formado recebe uma demanda de análise de um banco de dados. Na dúvida sobre as condições do uso da regressão logística, busca nas referências a teoria dessa técnica. Sobre uma regressão logística binária é correto afirmar que seu uso
Considere o conjunto de dados dos funcionários de uma empresa em que estão disponíveis as variáveis X e Y, sendo a variável X uma variável categórica que contém a função que o funcionário desempenha na empresa e a variável Y uma variável numérica com os salários dos funcionários. Para calcular o valor médio dos salários de acordo com a função desempenhada na empresa utilizando o software R pode-se executar o comando:
Deseja-se obter uma equação que descreva o comportamento da variável Y=salário dos funcionários da empresa A em função da variável X=tempo em que trabalha na empresa e verificar se essa relação é estatisticamente significativa. Dispõe-se do arquivo dados no formato RData no qual estão armazenadas as variáveis X e Y. A forma correta para obter a equação de uma regressão linear simples e verificar se o modelo ajustado é significativo, utilizando o software R é dada por:
Ao realizar um teste de hipóteses, o pesquisador pode chegar a uma decisão correta como também pode tomar uma decisão incorreta, sendo possível a ocorrência de dois tipos de erros: rejeitar a hipótese nula quando ela é verdadeira ou falhar em rejeitar a hipótese nula quando ela é falsa. O que é o nível de significância (geralmente representado por α) em um teste de hipóteses?
Para responder à questão de número 54, utilize o teste estatístico adequado considerando o nível de 0,05 de significância. Dado φ(1,645)=0,95 e φ(1,96)=0,975; sendo φ a função de distribuição acumulada normal padrão.
O tempo médio de utilização de um eletrodoméstico, tem, supostamente, distribuição normal com média de 10 meses. Com o objetivo de prolongar o tempo de utilização deste aparelho, os fabricantes incluíram um novo material, mais resistente, no processo de fabricação. Após a inclusão do novo material, foram testados 16 aparelhos, obtendo-se respectivamente os valores de 12 e 3 para a média e desvio padrão amostrais. Esses resultados mostram evidências do aumento do tempo de utilização do eletrodoméstico?
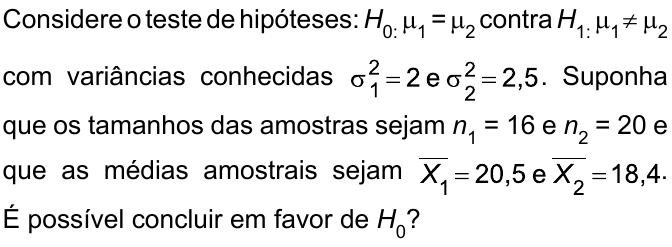
Para responder à questão de número 56, considere o teste estatístico adequado. Considere o nível de significância de 0,05. Dado φ(1,645)=0,95, φ(1,96)=0,975, F(1,691)=0,95, F(2,03)=0,975, sendo φ a função de distribuição acumulada normal padrão e F a função de distribuição acumulada t de Student com 34 graus de liberdade.
Seja uma população com 20 elementos. Considerando uma amostragem aleatória simples sem reposição, quantas amostras distintas de 3 elementos pode-se obter?
Seja uma população de 20 indivíduos (N=20), da qual se deseja selecionar uma amostra sistemática simples com intervalo de seleção definido K=4. A probabilidade de inclusão (πᵢ) de uma unidade i qualquer na amostra é dada por:
Um empresário acredita que o tempo gasto por seus funcionários no deslocamento até a empresa é superior a 30 minutos. Caso isto se confirme pretende propor uma medida para reduzir o tempo gasto. Para verificar se está correto decidiu coletar o tempo de deslocamento de uma amostra de 15 funcionários, que informaram o tempo gasto com o deslocamento, obtendo os valores, em minutos: 20, 45, 30,35, 32,38, 45, 20, 25,36, 30, 40, 13, 40, 50. O empresário utilizará o software R para realizar um teste de hipóteses considerando H₀ : µ = 30 contra H₁ : µ > 30. Qual sequência de comandos ele pode utilizar?